TITLE
OpenAIのGPT-6.2、同じ仕事をより少ないトークンで
投稿日:2026.11.19
CATEGORY
- AI開発
AIをエージェント的に使うほど、出力トークンの量がそのまま請求額に跳ね返ります。入力を短くする工夫だけでは、出力が長くなる作業のコストは下がりません。OpenAIが2026年11月17日(米国時間)に発表した「GPT-6.2 Astra」「GPT-6.2 Sol」は、この出力側のコストに踏み込んだ発表でした。同じ、あるいはそれ以上の成果を、より少ない出力トークンで出す——これが今回の発表で前面に出ている軸です。
GPT-6.2 Astra と GPT-6.2 Sol、何が変わったか
Astra は複雑な専門業務向けの最上位モデルで、2026年9月公開の GPT-6 Astra の後継です。Sol は日常業務向けの効率的な汎用モデルで、GPT-6.1 Sol の後継にあたります。最上位モデルと効率型モデルの二本立てという構造自体は前バージョンから続いていますが、今回はどちらも「少ない出力トークンで成果を高めた」点が共通しています。
Impress Watch の報道によれば、Astra はスライド・表計算・文書作成でテンプレートや分野の慣例によりいっそう忠実に従うようになり、Webサイト・ゲーム・3Dフロントエンドも見栄えよく動くものを作れるようになりました。コンピューター操作の精度も上がり、CADやシミュレーションツールで部品や接続部まで扱えるとされています。Sol はエージェントとしての連続処理・コーディング・文章作成が改善されたと報じられています。
コスト効率とベンチマークの数字
OpenAIが公開した複数のベンチマークでは、スコアが上がったのと同時にコストが下がっている、という組み合わせが共通しています。ただし「コスト」の中身は一様ではありません。Astra は GPT-6 Astra からの価格改定(後述)自体で単価が下がっており、出力トークンの量そのものが減ったと明示されているのは GDPval v2 の1件だけです。主な数値は次のとおりです(いずれも OpenAI 発表によるベンチマーク値で、第三者による再現検証は確認できていません)。
| ベンチマーク | スコア差 | コスト |
|---|---|---|
| Agents' Last Exam | GPT-6 Astra比 +5.2pt | タスクあたり1/3未満 |
| 対 Claude Fable 5.2(※9課題除外の比較) | +5.5pt | 約5% |
| Terminal-Bench-Science 0.1 | GPT-6 Astra比 +9pt | 1/3未満 |
| GDPval v2(社内ベンチマーク) | GPT-6 Astra比 +6.2pt | 出力トークン22%減 |
| FrontierCode 2.0(Sol) | Astra比 0.5pt以内の差 | 約1/5 |
| LifeVal(Sol) | Astra超のスコア | 約1/7 |
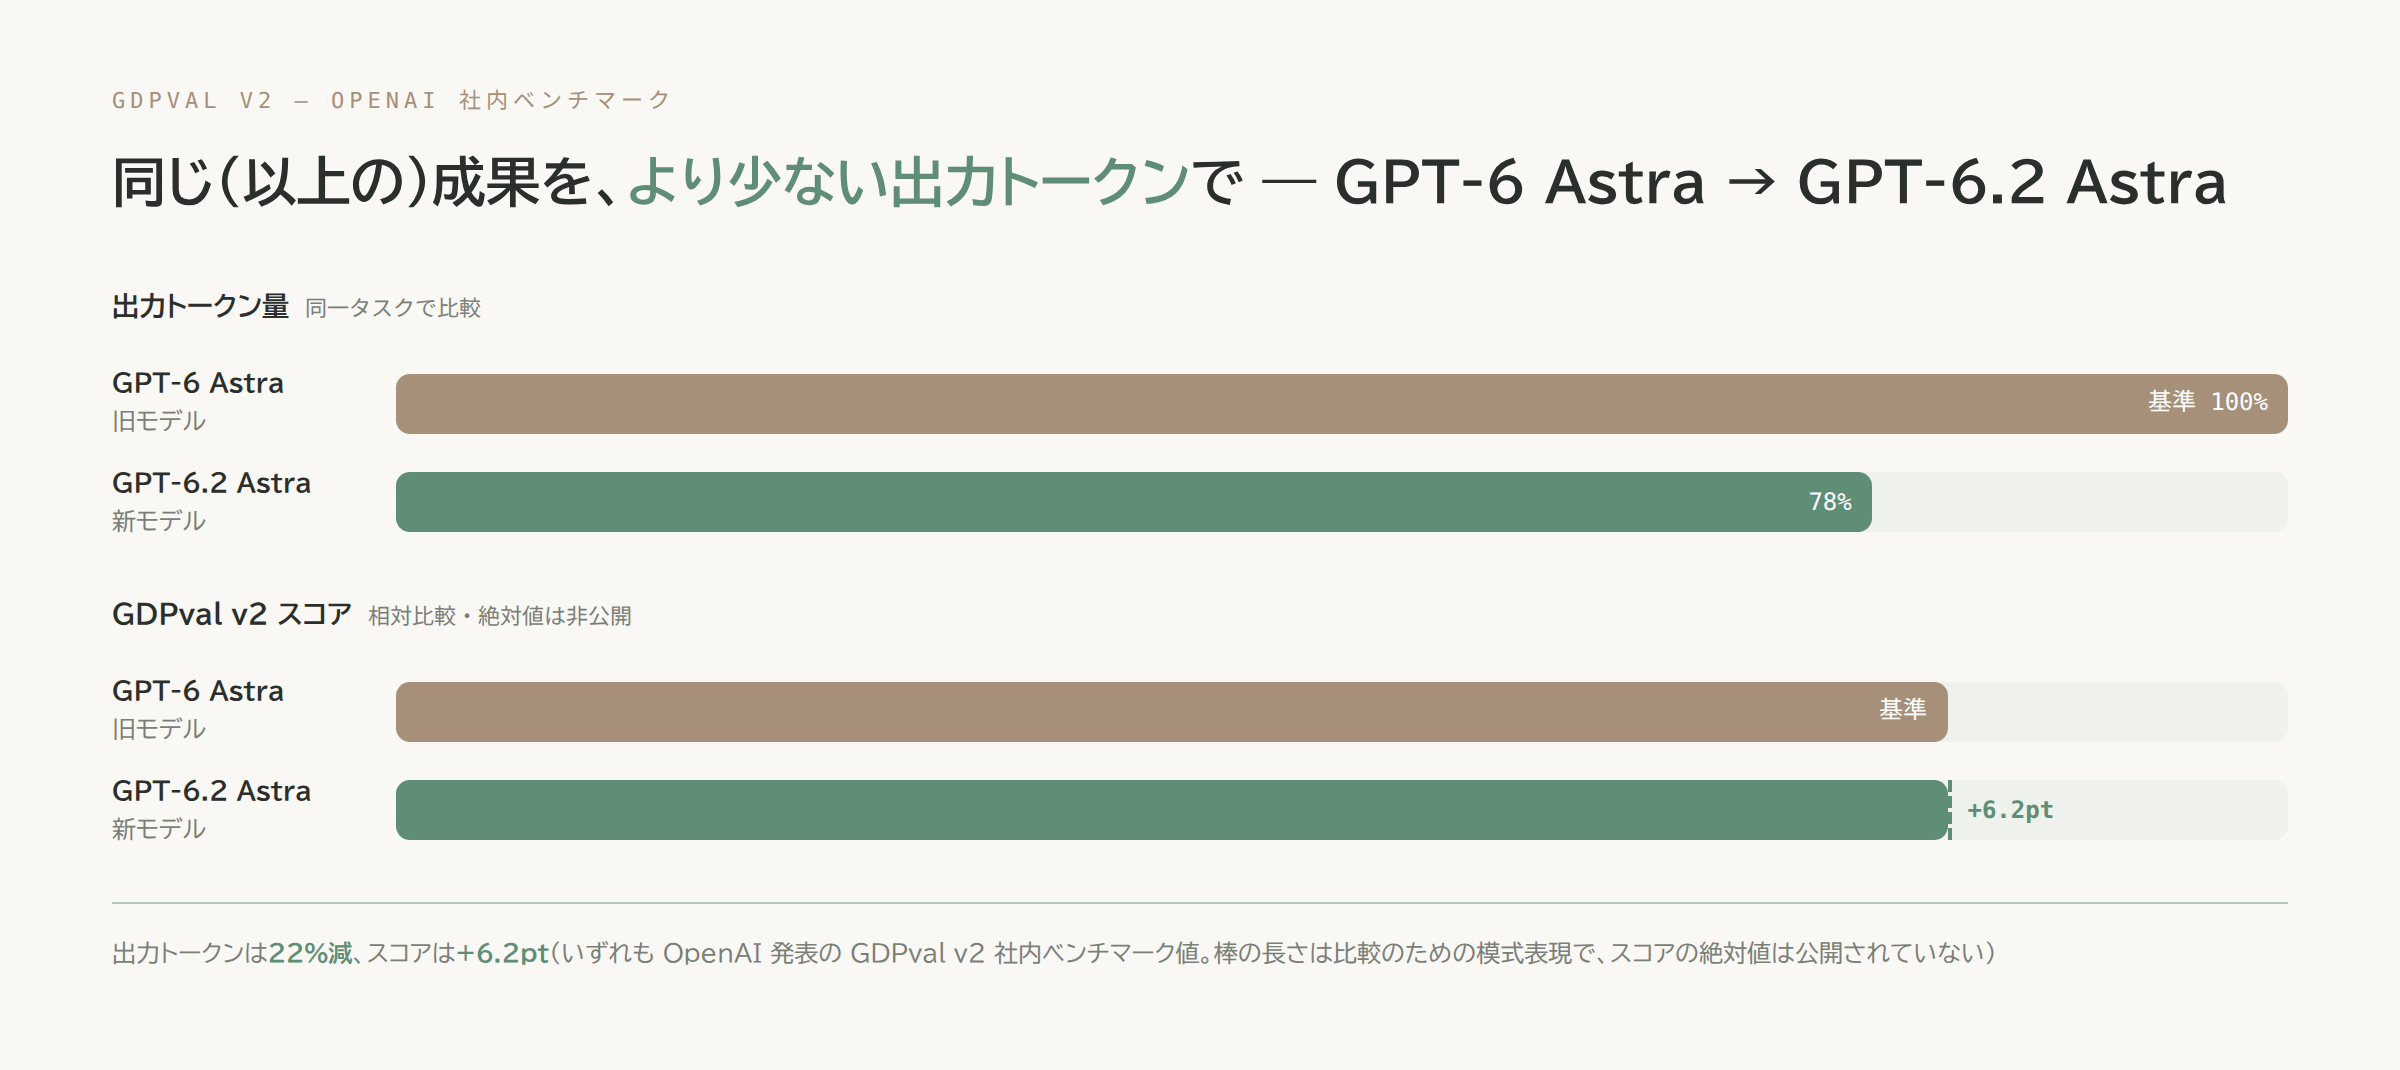
GDPval v2 の数字(スコア +6.2pt、出力トークン22%減)が、今回の発表が言う「少ないトークンで、同じ成果を」を最も具体的に示しています。Sol 側では、FrontierCode 2.0 が Astra に近いスコアを約1/5のコストで、LifeVal が Astra を上回るスコアを約1/7のコストで出しているという主張で、効率型モデルの位置づけが数字に表れています。
料金とモデルの使い分け、実務への影響
API料金(100万トークンあたり)は、Astra が入力8ドル・キャッシュ済み入力0.40ドル・出力40ドルで、GPT-6 Astra より入出力とも20%安く、キャッシュ済み入力は60%安くなりました。Sol は入力2ドル・出力10ドルで、GPT-6.1 Sol から価格は据え置きです。API のモデル名は gpt-6.2-astra と gpt-6.2-sol です。
提供面では、ChatGPT の Plus・Pro・Enterprise・Edu プランで「ChatGPT Work」と「Codex」から発表当日より利用できます。Pro 500加入者は両モデルで、Pro 200加入者は Sol のみ、高速応答モード(Ultrafast)を使えるとされています。業務での使い分けを考えるなら、専門性の高い一回性の作業は Astra、日常的に繰り返すエージェント処理は Sol、という分担が料金差とも整合します。
コスト効率という基準を、導入検討にどう使うか
精度の比較表だけを見ていると、「同じ成果に必要な出力トークン数」という軸が抜け落ちます。GDPval v2 の数字が示すように、スコアが上がったことと、そのために必要なコストが下がったことは別の事実で、どちらも確認してはじめて導入判断の材料になります。トークン数が減っても出力の網羅性や品質が保たれているかは、公開されたベンチマーク値だけでは判断しきれません。実際の業務データで試してから判断する価値があります。
この発想は、AIエージェントを複数組み合わせて使う現場でも見覚えがあります。私たちも、タスクの難易度に応じてモデルの階層を分け、並列実行するワーカーには出力コストの低いモデルを割り当て、高度な判断が必要な場面だけ上位モデルを使う運用をしています。GPT-6.2 の Astra・Sol の位置づけは、この「最上位モデルと効率型モデルを使い分ける」という考え方に近いと見ています。
少ないトークンで、同じ成果を測る視点
次にAIベンダーの提案書や見積もりを受け取る場面では、精度のベンチマーク値だけでなく「同じ成果に必要な出力トークン数」も並べて確認すると、何にいくら払っているかの解像度が上がります。今回の GPT-6.2 の料金表・ベンチマーク値は、その比較を自社の見積もりで試す具体的な材料になります。
関連
AI エージェントを業務で回すときの設計と運用については、CTO の note に書いています。
出典
- OpenAI 公式発表: Introducing GPT-6.2 Astra & Sol
- Impress Watch: OpenAI、新モデル「GPT-6.2 Astra」「GPT-6.2 Sol」を発表
※ この記事は AI を使用しています。Leadeas が自社開発した AI エージェント基盤で下書きを作成し、人間のレビューを経て公開しています。AI ネイティブ開発会社として自社の技術をそのまま実演する目的で、この手法を用いています。(詳しくは AI 利用ポリシー)
RELATED関連記事
Microsoft が「MAI Code 2」を発表——GitHub Copilot に自社モデルを投入し、OpenAI・Anthropic 依存を下げる動き
AI開発