TITLE
「Grok 4.7」は価格据え置き、独立ベンチマークでは明確な差 ─ AIモデル選定で見るべきはベンチマークの中身
投稿日:2026.09.22
CATEGORY
- AI活用
xAI が2026年9月21日、新モデル「Grok 4.7」を発表しました。価格は入力 $2 ・出力 $6(100万トークンあたり)で、前世代の Grok 4.6 と同じです。ただし独立系ベンチマークでは、Claude や GPT-6 系の大型モデルとの間に明確な差が示されています。価格が同じでも、性能まで同じとは限りません。
Grok 4.7 の発表内容: 価格は据え置き、中身は大型化
Grok 4.7 は、より大規模なベースモデルを採用し、長時間実行タスク向けの強化学習を拡張したモデルです。xAI は自己検証能力の向上を発表しており、会話タスク・知識作業向けの最適化と新しいセーフガード技術の実装も併せて発表しています。報道によれば、パラメータ数は約2.1兆(前世代の Grok 4.6 から約40%増)、コンテキストウィンドウは50万トークンとされています。
価格体系は前世代から変えていません。入力 $2・出力 $6(100万トークンあたり)で、xAI 自身「Grok 4.6 と同じ価格と速度」と説明しています。処理速度を優先する高速版も用意されており、こちらは出力速度が2倍になる代わりに価格も2倍です。
xAI が公式に示したベンチマークは次のとおりです。
- CursorBench 4.0(ソフトウェアエンジニアリング): 46.3%
- DeepSWE v1.1: 71.0%
- EEBench(電気工学): 64.0%
- LatchBio 生物安全ベンチマーク: 62.4%
いずれも xAI 自身が選び、xAI 自身が測定した数字です。この点が、次に見る独立検証との差を理解するうえで重要になります。
独立検証との差: 総合指数でもエージェントコーディングでも後れ
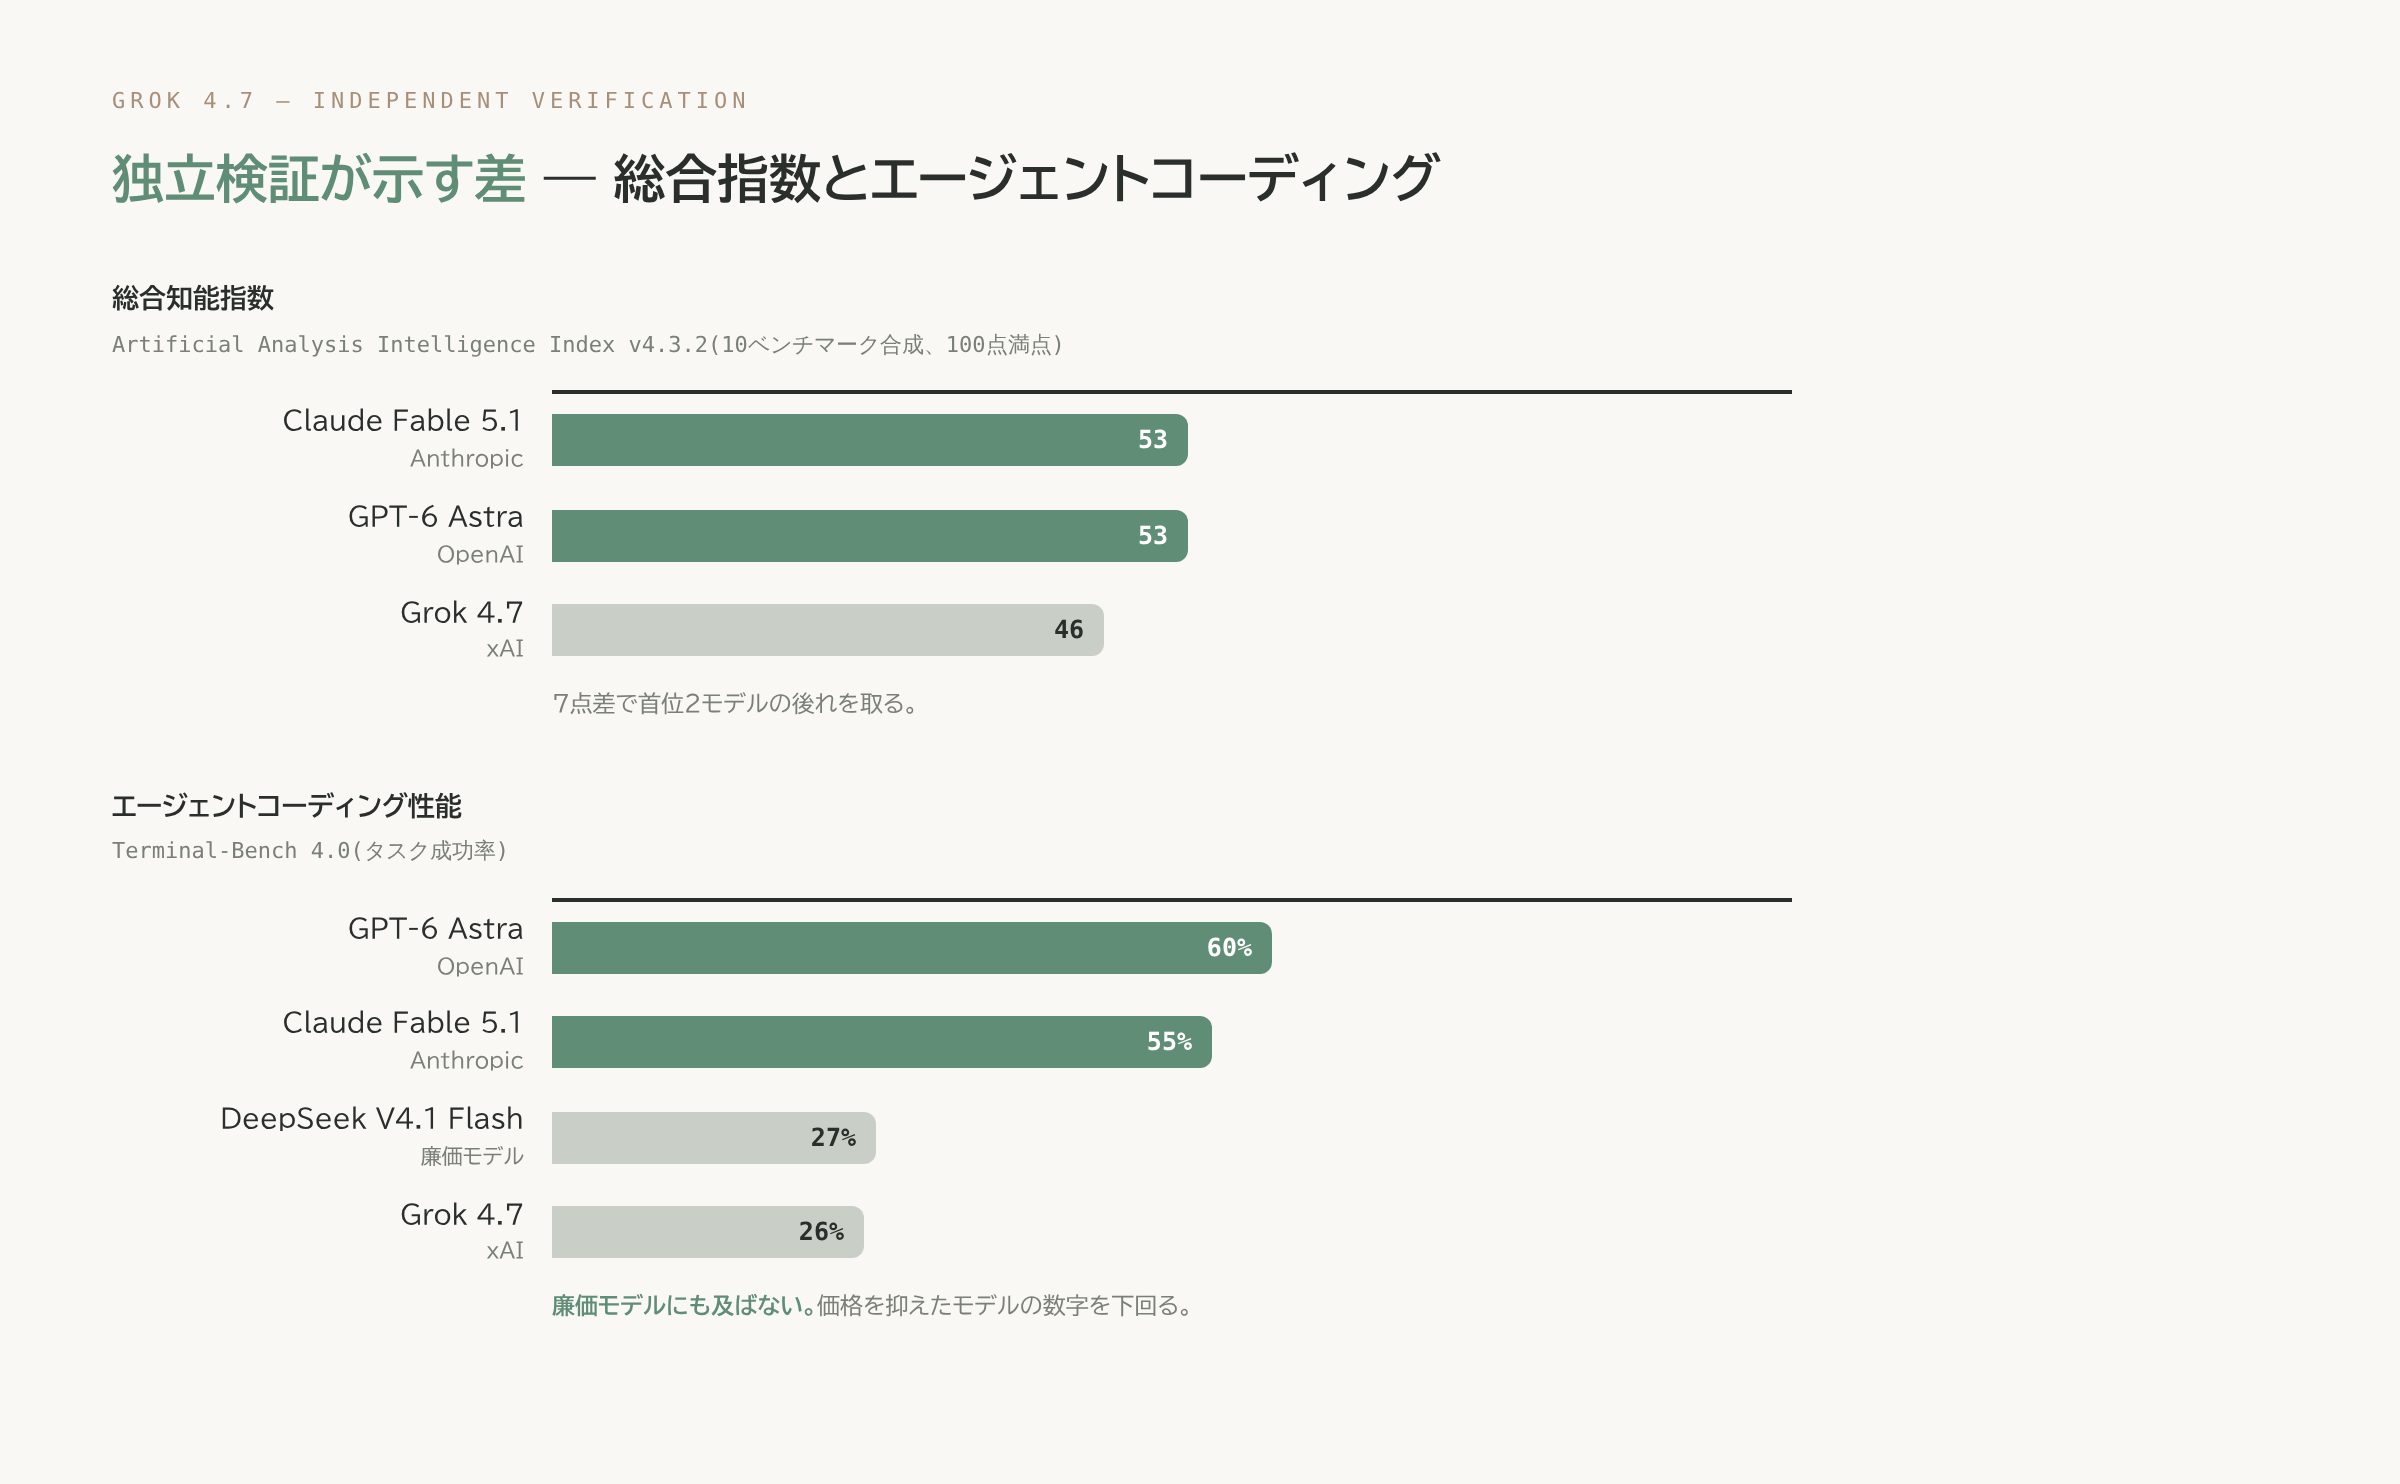
第三者検証メディアの the-decoder.com が伝えた独立ベンチマークの結果は、xAI の発表とは異なる姿を映し出しています。10種のベンチマークを合成した Artificial Analysis Intelligence Index(v4.3.2)の総合スコアで、Grok 4.7 は46点。首位の Claude Fable 5.1 と GPT-6 Astra はそろって53点で、Grok 4.7 は7点差の後れを取っています。
差がより際立つのは、エージェントコーディング性能を測る Terminal-Bench 4.0 です。Grok 4.7 のスコアは26%。GPT-6 Astra の60%、Claude Fable 5.1 の55%と比べると半分に届きません。さらに、廉価モデルとして位置づけられる DeepSeek V4.1 Flash が27%を記録しており、Grok 4.7 はこの廉価モデルにも数字の上で及びません。
開発者本人のコメントも、この独立検証と同じ方向を指しています。Musk は Grok 4.7 について「Opus 5.0とほぼ同等、5.1には届かない。得意不得意がある」と述べています(自社モデルへの前向きな発言も含まれる自己申告である点は割り引く必要がありますが、独立検証のギャップを否定する発言ではありません)。
なぜ公式発表と独立検証でこれほど差が出るのか
xAI が公式に示した数字と、独立系メディアが計測した数字の間には、無視できない開きがあります。この差が生まれる理由は、比較しているベンチマークの性質が違うためと考えられます。
xAI が公式ベンチマークとして挙げた CursorBench・DeepSWE・EEBench・LatchBio は、いずれも特定領域に絞った個別ベンチマークです。どの指標を選んで公表するかは発表元の裁量に委ねられており、得意な領域だけを切り出して示すことも技術的には可能です。
一方、Artificial Analysis Intelligence Index は10種のベンチマークを合成した総合指数で、Terminal-Bench はエージェント型コーディングという実務に近いタスクを対象にしています。どちらも第三者が独自に測定したもので、発表元が指標を選べません。「公式発表の個別ベンチマークで良好」という事実と、「第三者の総合指数・実務タスクで明確な差」という事実は、矛盾しているわけではなく、測っているものが違うだけです。
企業のモデル選定で実際に見るべきこと
この構図は Grok 4.7 に限った話ではありません。新しいモデルが発表されるたびに、価格の安さや一部ベンチマークの高スコアだけが強調されて広まりやすい、という傾向自体が繰り返し起きています。
私たちは複数の AI モデルを使い分けていますが、新しいモデルを重要な判断に使う前には、公表されたベンチマークの数字だけでなく、実際の業務タスクで既存モデルと並走させて所見を比較してから採用を決めています。公表スペックと実際の挙動は、必ずしも一致しないためです。
企業がモデル選定で確認すべき点は、次の3つに絞れます。
- どのベンチマークで測った数字か: 発表元が選んだ個別ベンチマークなのか、第三者による総合指数なのかを区別する
- 自社の用途に近いベンチマークか: コーディング支援に使うなら、電気工学や生物安全のベンチマークではなく Terminal-Bench のようなエージェントコーディング系の数字を見る
- 価格差に見合う性能差があるか: 安いモデルが性能でも劣らないとは限らない。Grok 4.7 は Terminal-Bench で廉価モデルの DeepSeek V4.1 Flash にも数字の上で及んでいない
まとめ
次に新しいモデルの発表を見るときは、公式ベンチマークの数字と併せて、Artificial Analysis のような第三者の独立検証が出ているかを検索して確認してください。Grok 4.7 は価格を据え置いたまま登場しましたが、独立検証が示す性能は前世代と同じ立ち位置ではありません。値札とスコアは別の情報です。
関連
AI エージェントを業務で回すときの設計と運用については、CTO の note に書いています。
出典
- xAI 公式: https://x.ai/news/grok-4-7
- the-decoder.com: https://the-decoder.com/xai-launches-grok-4-7-at-bargain-prices-but-benchmarks-reveal-a-wide-gap-to-claude-and-gpt-6/
※ この記事は AI を使用しています。Leadeas が自社開発した AI エージェント基盤で下書きを作成し、人間のレビューを経て公開しています。AI ネイティブ開発会社として自社の技術をそのまま実演する目的で、この手法を用いています。(詳しくは AI 利用ポリシー)
RELATED関連記事
ChatGPT Images 2.5登場、画像生成AIの業務利用はどう変わるか
AI活用