TITLE
PostgreSQLの新拡張「pg_vectorsearch」とPRISM — pgvectorのHNSWよりどれだけ速いか
投稿日:2026.10.15
CATEGORY
- AI開発
PostgreSQLの新拡張「pg_vectorsearch」とPRISM — pgvectorのHNSWよりどれだけ速いか
PostgreSQLをベクトル検索やRAG基盤に使う際、データ量がメモリに対して大きくなると、pgvectorのHNSW(近傍探索のための多層グラフ構造インデックス)の構築に時間がかかる、という課題があります。Tiger Data(旧社名Timescale)は2026年10月13日、この課題に対する新しいオープンソースPostgreSQL拡張「pg_vectorsearch」を公式ブログで発表しました。独自インデックス方式「PRISM」を採用しており、公式ベンチマークでは1億ベクトル規模でHNSWのビルドに42時間かかったのに対し、PRISMは49分で完了しています。
PRISMの仕組み — クラスタ分割と圧縮コード
pg_vectorsearchが採用する「PRISM」(Partitioned Routing Index for Similarity Matching)は、ベクトルをクラスタに分割し、圧縮コード(RaBitQ、おおよそ1次元あたり1ビット)として格納するインデックス方式です。pgvectorのHNSWが多層グラフを辿って近傍を探索するのに対し、PRISMはベクトル空間をあらかじめ区画(パーティション)に分け、各区画の中身を圧縮したコードとして保持します。
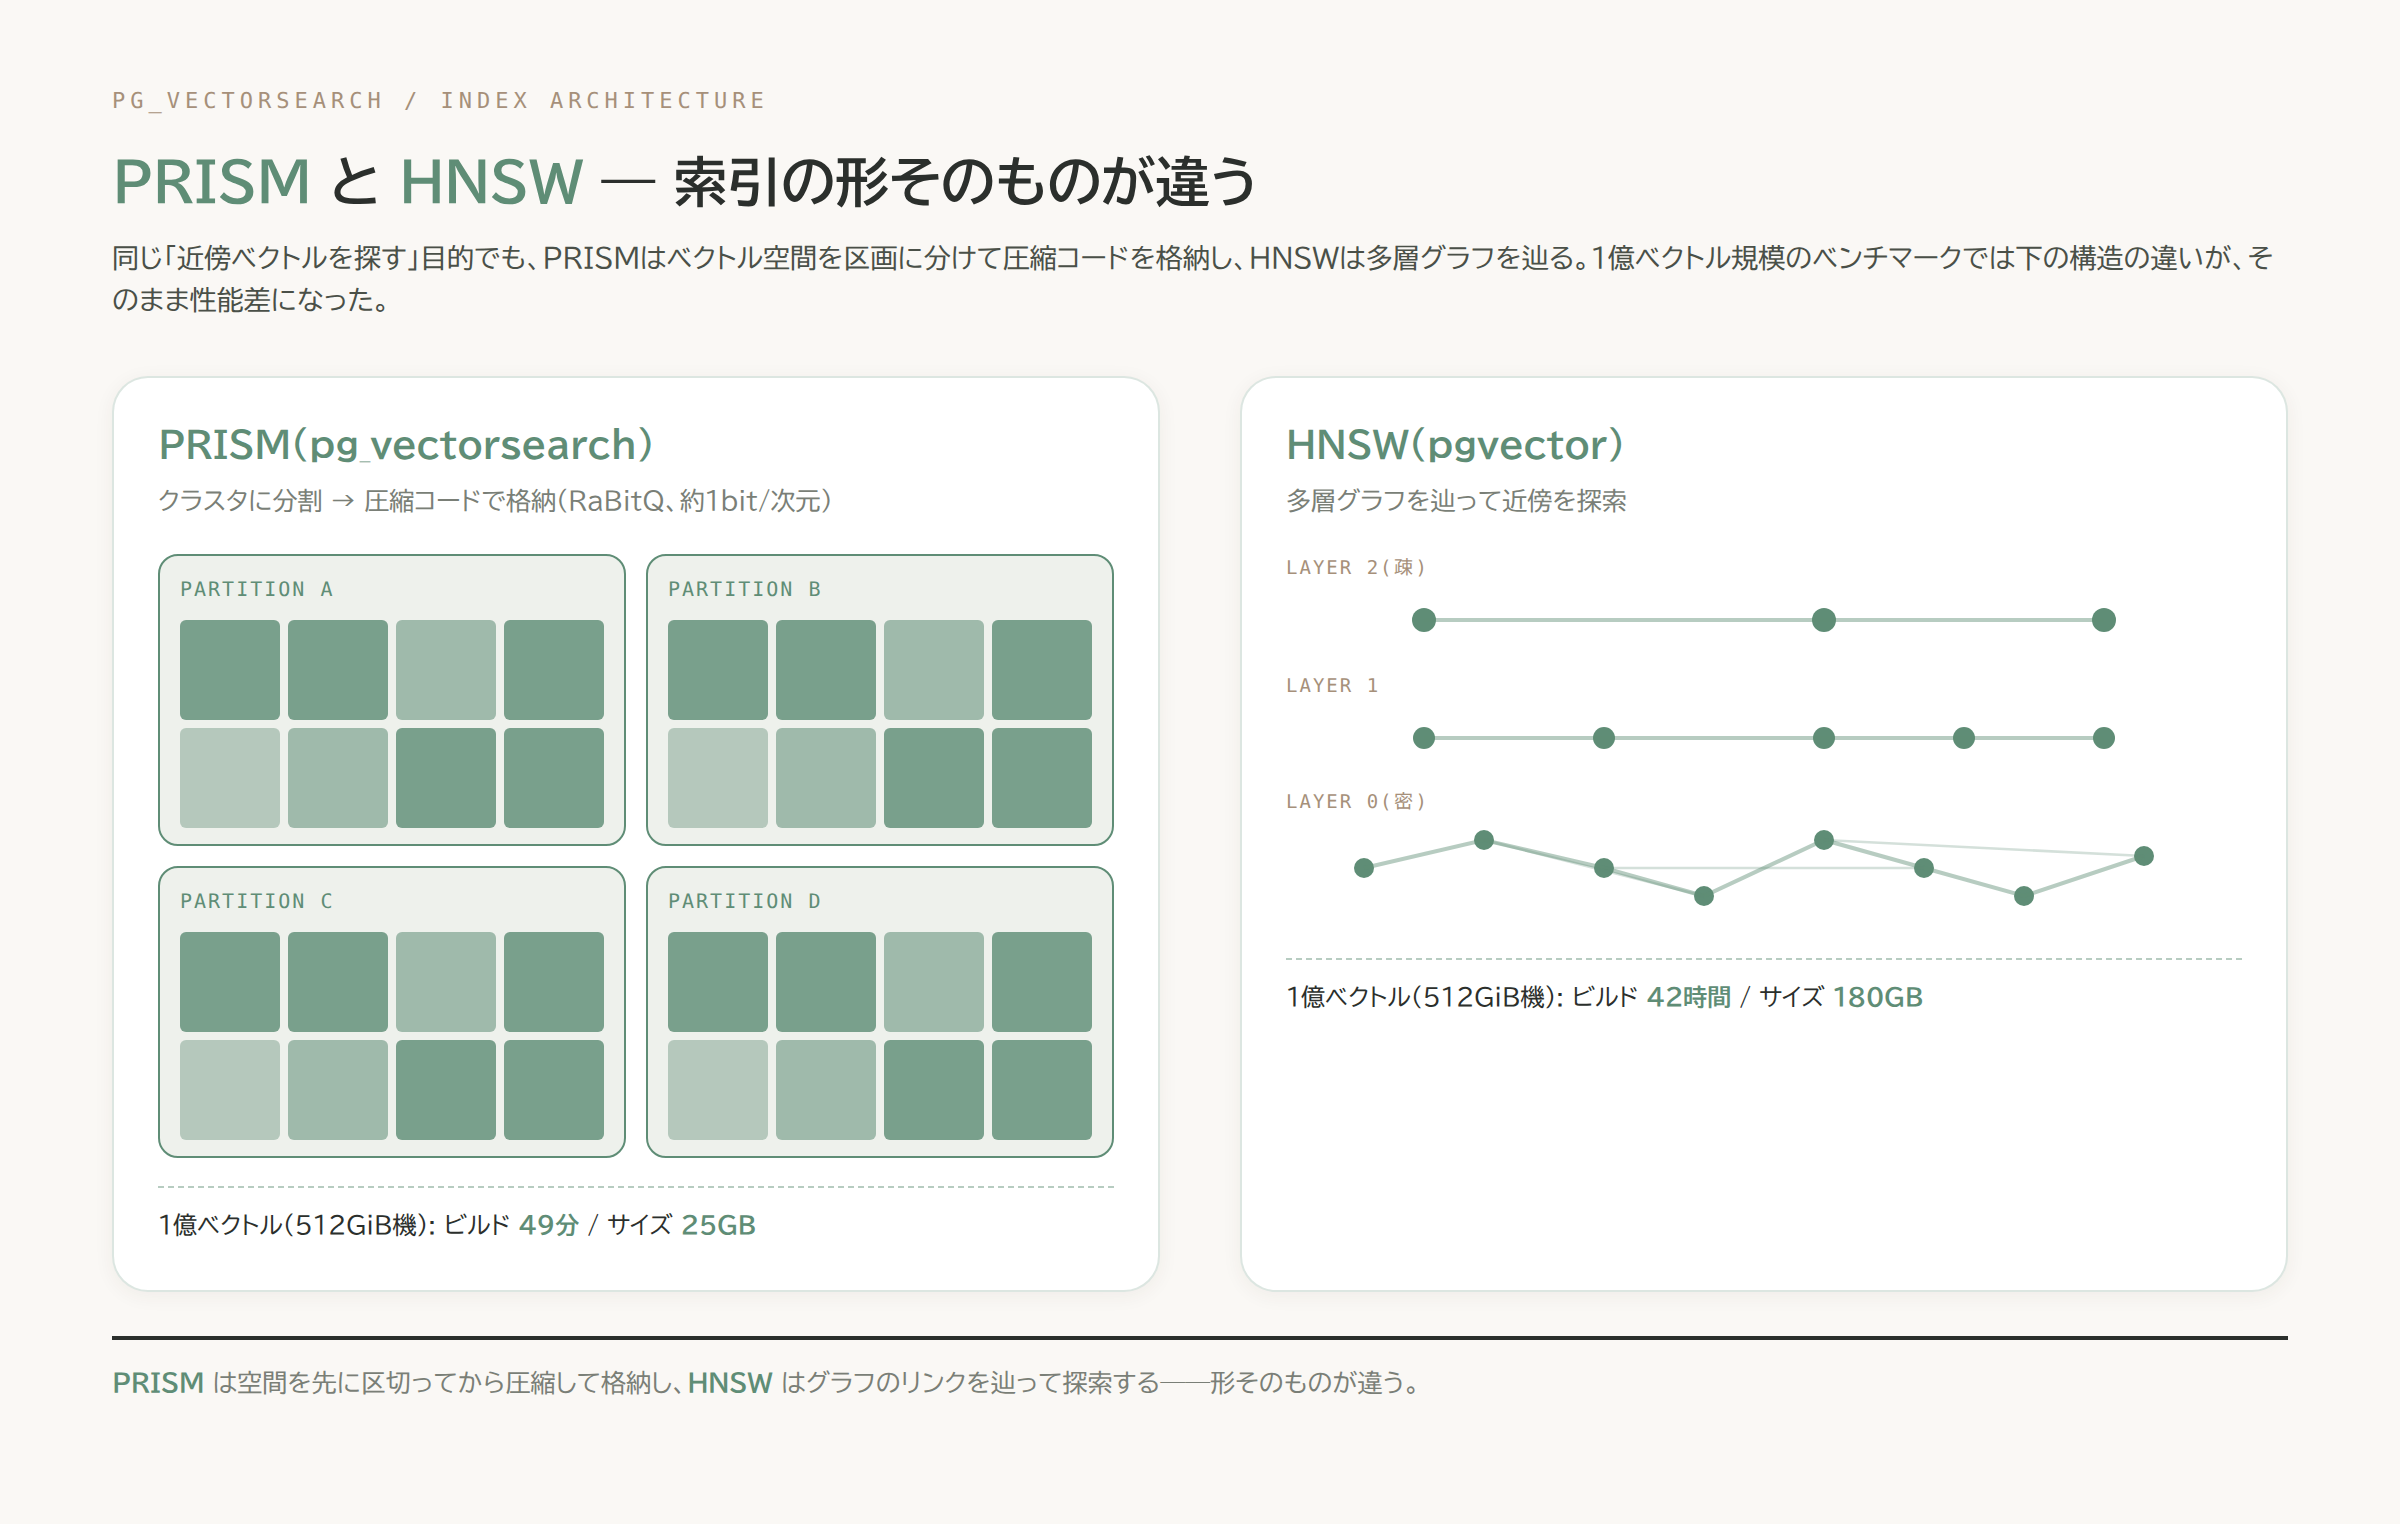
pg_vectorsearchはPostgreSQL Licenseで公開されているオープンソース拡張で、要件はPostgreSQL 18以降です。ソースコードはGitHubで公開されています。
1億ベクトルのベンチマーク — ビルド42時間から49分へ
Tiger Data公式ブログは、Cohereのembeddingsを使い、総当たりの厳密探索と比較したrecall@10のベンチマークを公開しています。1億ベクトル規模での結果は次のとおりです。
| 方式 | インスタンス | メモリ | ビルド時間 | インデックスサイズ | p50レイテンシ(recall95%) | p50レイテンシ(recall99%) |
|---|---|---|---|---|---|---|
| PRISM | r8i.4xlarge | 128GiB | 1時間40分 | 25GB | 6ms | 21ms |
| PRISM | r8i.16xlarge | 512GiB | 49分 | 25GB | 4ms | 19ms |
| HNSW | r8i.16xlarge | 512GiB | 42時間 | 180GB | 8ms | 未達 |
HNSWは128GiBのマシンでは構築そのものが完了しませんでした。512GiBマシンでの42時間というビルド時間も、recall99%のレイテンシが測定できなかった(未達)という結果も、PRISMの49分・25GBという数字と並べると差が際立ちます。
100万ベクトルでも同じ傾向 — 小規模でも差は縮まらない
規模を100万ベクトルまで落としても、傾向は変わりません。
| 方式 | インスタンス | メモリ | ビルド時間 | インデックスサイズ | p50レイテンシ(recall95%) | p50レイテンシ(recall99%) |
|---|---|---|---|---|---|---|
| PRISM | c8g.medium | 2GiB | 約3分 | 280MB | 9ms | 15ms |
| PRISM | c8g.large | 4GiB | 約3.1分 | 280MB | 3ms | 9ms |
| HNSW | c8g.large | 4GiB | 約21.7時間 | 2.05GB | 122ms | 392ms |
HNSWは2GiBのマシンでも、構築が完了しませんでした。なお、これらの数値はTiger Data自身によるベンチマークであり、第三者による検証ではありません。また公式ブログが示しているのはHNSWとの比較のみで、同じpgvector拡張が持つIVFFlat方式との直接比較数値は公開されていません。
アルファ版としての制約 — 自動リバランスはまだ無い
Tiger Data自身が、pg_vectorsearchは現時点でアルファ版であると明言しています。挙げられている制約は次のとおりです。
- インサートやアップデートが多いワークロードでは、recallが時間とともに劣化しうる。自動リバランス機能はまだ実装されておらず、
prism_rebalanceまたはREINDEXを手動で実行する必要がある - 削除された領域は
REINDEXを実行するまで再利用されない - 空のテーブルに先にインデックスを作成し、後からデータを流し込むという使い方は推奨されていない
ベンチマークの数字だけを見ると魅力的ですが、書き込みが継続的に発生する本番のワークロードでは、この手動リバランスの運用コストを合わせて見積もる必要があります。
GAに向けた計画 — pgvectorscaleはメンテナンスモードへ
Tiger DataはGA(正式版)に向けて、自動インクリメンタル・リバランス、フィルタ付きストリーミング検索(WHERE句とORDER BY句の組み合わせ)、レプリケーション・バックアップ復元・マルチクライアントスループットの堅牢化を計画していると説明しています。さらにその先として、並列クエリ実行・複数カラムインデックス・VACUUMによるディスク回収・10億ベクトル規模でのベンチマークも挙げられています。
これに伴い、Tiger Dataが従来提供してきた拡張「pgvectorscale」はメンテナンスモードに移行します。pg_vectorsearchが、pgvectorscaleに代わる位置づけです。
まとめ
PostgreSQLをベクトル検索やRAG基盤として検討している場合、最初に確認する価値があるのは自社の書き込み頻度(インサート・アップデートの量)です。読み込み中心のワークロードであれば、今回のベンチマーク数値(1億ベクトルでビルド49分・25GB)は参考になりますが、embeddingの次元数やインスタンス構成が自社の環境と異なる場合は、同じ条件での再現性まで確認する価値があります。書き込みが継続的に発生するワークロードでは、自動リバランスがまだ無くREINDEXが手動前提というアルファ版特有の制約を、Tiger Data自身が同じ公式ブログの中で明記しているとおり、運用コストとして合わせて見積もる必要があります。
関連
AI エージェントを業務で回すときの設計と運用については、CTO の note に書いています。
出典
- Tiger Data公式ブログ「Announcing pg_vectorsearch: Scalable, Open Source Vector Search for PostgreSQL」(2026年10月13日公開) https://www.tigerdata.com/blog/announcing-pg_vectorsearch-scalable-open-source-vector-search-postgresql
- pg_vectorsearch リポジトリ https://github.com/timescale/pg_vectorsearch
※ この記事は AI を使用しています。Leadeas が自社開発した AI エージェント基盤で下書きを作成し、人間のレビューを経て公開しています。AI ネイティブ開発会社として自社の技術をそのまま実演する目的で、この手法を用いています。(詳しくは AI 利用ポリシー)
RELATED関連記事
Cloudflareの「Web Search API」とは——AI Gatewayで選べる3つの検索プロバイダーと28倍の価格差
AI開発