TITLE
ELYZA、国産基盤「LLM-jp-4」から推論特化AIを無料公開 — 商用利用可能な選択肢が増えた
投稿日:2026.10.03
CATEGORY
- AI開発
KDDI傘下のAI開発企業ELYZA(東京都文京区)が、2026年10月2日、推論に特化したAIモデル2種をHugging Face上で無料公開しました。ベースは国立情報学研究所(NII)が一から開発した国産基盤モデル「LLM-jp-4」で、ライセンスはApache 2.0——改変・再配布・商用利用を広く許可する形で提供されています。
公開されたのは、Dense型(ネットワーク全体を使って推論する一般的な構成)の「ELYZA-Thinking-1.0-llm-jp-4-33b」と、MoE型(入力ごとにネットワークの一部だけを使う計算効率型の構成)の「ELYZA-Thinking-1.0-llm-jp-4-32b-a3b」の2モデルです。NIIが9月28日に発表した改良版「LLM-jp-4.1」よりも一部ベンチマークで高いスコアを記録しており、国産・オープン・商用利用可という3条件を同時に満たすモデルの選択肢が、また一つ増えたことになります。
土台はNII、仕上げはELYZA — 二層構造で生まれた推論モデル
ELYZAが今回公開したモデルは、ゼロから学習させたものではありません。土台になっているのは、NIIが開発した基盤モデル「LLM-jp-4」シリーズで、33bモデルの具体的なベースは llm-jp/llm-jp-4-33b-base です。ELYZAはこの基盤モデルに対して推論力を伸ばすための後処理(ポストトレーニング)を施し、「Thinking」と名の付く推論特化モデルに仕立てました。
基盤そのものを作ったのはNII、そこに推論力という専門性を上乗せしたのはELYZAです。この役割分担自体は珍しいものではありません。海外でも基盤モデルを独自にファインチューニングして専門特化モデルを出す例は一般的で、構造としては同型です。違うのは、土台が国産の基盤モデルだという点です。
推論力を鍛えた三段階の学習プロセス
ELYZAがモデルカードで公開している学習プロセスは、3段階に分かれています。
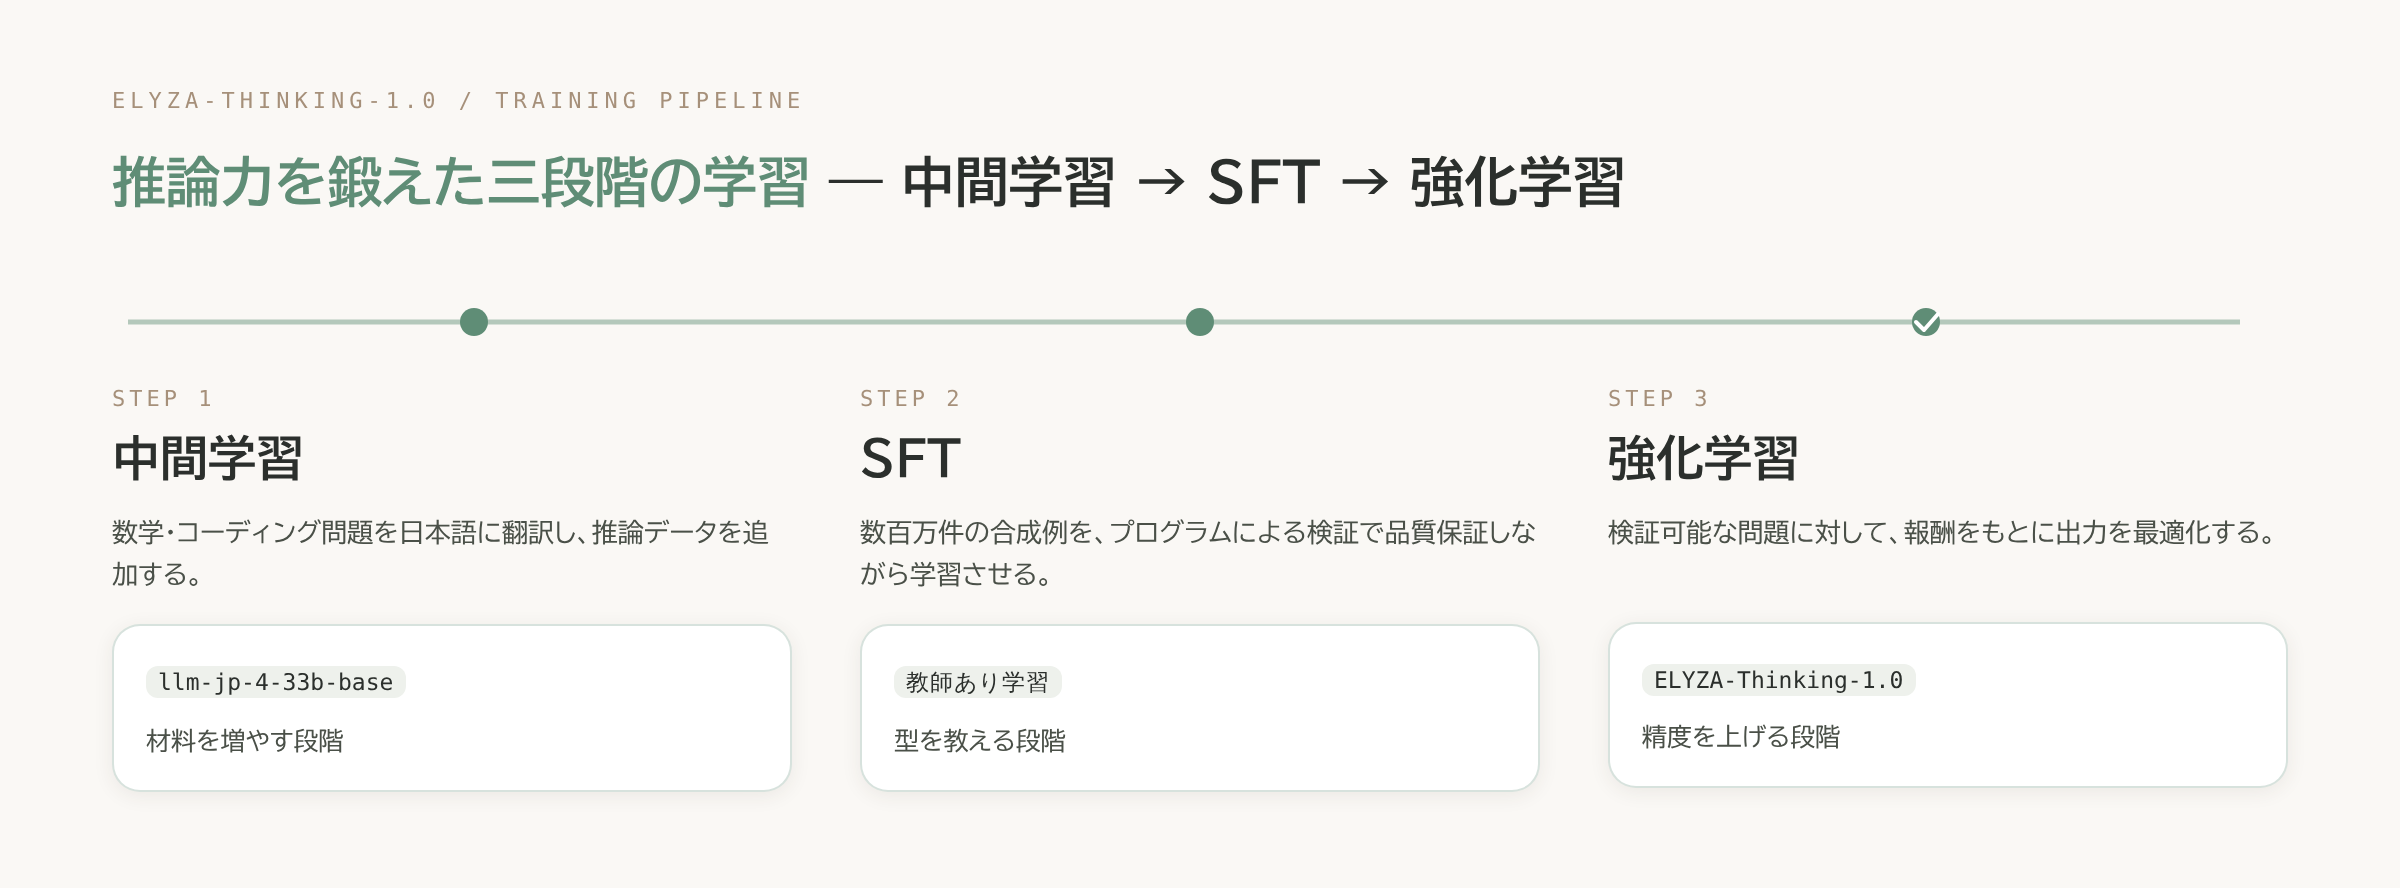
第一に中間学習です。数学やコーディングの問題を日本語に翻訳し、推論のための学習データを追加する段階です。第二に教師あり学習(SFT)です。数百万件規模の合成例を使い、プログラムによる検証で品質を担保しながら学習させます。第三に強化学習です。検証可能な問題に対して、報酬をもとにモデルの出力を最適化する段階です。
中間学習で推論の材料を増やし、SFTで型を教え、強化学習で精度を上げる——この順番自体は、近年の推論特化モデル開発で広く採られている構成に重なります。目新しいのは手法そのものよりも、国産基盤モデルに対してこの3段階を一通り適用し、結果をApache 2.0で無料公開した点です。
ベンチマークが示す「国産オープン」の到達点
ELYZAが公開しているベンチマーク結果は次の通りです。
- 日本語MMLU: 84.69%
- 英語MMLU-Pro: 77.53%
- 日本語数学: 90.00%
比較対象も見ておく必要があります。NIIは9月28日に、LLM-jp-4の事後学習を改善した「LLM-jp-4.1」シリーズを発表していました。ELYZAが10月2日に公開したモデルは、この4.1シリーズの一部ベンチマークを上回るスコアを記録しています。同じ基盤モデルの系譜から、公式の改良版よりも高いスコアを出す派生モデルが4日後に出てきた格好です。
なぜELYZAのモデルが上回ったのか(投入データ量・学習手法・評価対象タスクの違いなど)は公開情報だけでは特定できないが、ベースモデルを公開する側(NII)と、そこに特定の目的で磨きをかける側(ELYZA)が分かれている構図から、こうした結果が生まれた一例ではあります。
「再帰的自己改善」という芽、まだ助走段階
ELYZAは同じ10月2日、もう一つ発表をしています。「AIでAIを開発して反復的に性能を高める『再帰的自己改善(RSI)』を推進する」研究組織、「ELYZA RSI Research」の設立です。
ただし、これは「RSIを実現した」という話ではありません。ELYZA自身が発表の時点で「RSIの前段階の要素研究」であり、「RSIそのものを実現したわけではない」と明記しています。今回公開された2モデルも、RSI研究の成果というより、研究組織発足と同じ日に示した実績に近いといえます。
AIがAIの学習データや評価を担う仕組みは、各社が研究テーマとして取り組んでいますが、実用段階に達した事例はまだ確認しにくい状況です。今回の発表も、研究の方向性を示す芽が出た段階として見ておくのが妥当です。
内製化・DX検討での論点
自社でAIモデルの採用を検討する担当者にとって、今回の公開が意味を持つのは次の3点です。
第一に、ライセンスです。Apache 2.0は改変・再配布・商用利用を広く許可するライセンスであり、社内システムへの組み込みや自社サービスへの転用を検討する際の制約が少なくなります。利用規約を個別に確認する必要がある閉じたAPI型のモデルとは、検討の進め方が変わります。
第二に、公開ベンチマーク数値が検証可能な形で示されている点です。日本語MMLUや日本語数学といった指標は、自社の想定用途(社内文書の要約、コーディング支援、問い合わせ対応など)と照らし合わせて、実際に試す価値があるかどうかを判断する材料になります。
第三に、研究組織の発表(RSI Research)と、今すぐ使えるモデルの公開を分けて見る必要がある点です。研究の方向性としての発表と、今日試せる実装としてのモデル公開は別物であり、どちらを評価するかで検討のスケジュール感は変わってきます。
まとめ
商用利用可能な国産モデルを検討する軸は、「海外クローズドAPIか、国産オープンモデルか」の二択だけでなく、同じ系譜内のどの派生版が自社の想定用途に合うかというベンチマーク特性の見比べも含むようになっています。少なくとも LLM-jp-4 という一つの系譜の中だけでも、NIIの公式改良版とELYZAの派生版という複数の選択肢が、数日のうちに並んで出てくるようになりました。ELYZAの今回の公開は、その比較対象のリストに新しい1行を加えた、という位置づけで見るのが妥当です。
関連
AI エージェントを業務で回すときの設計と運用については、CTO の note に書いています。
出典
※ この記事は AI を使用しています。Leadeas が自社開発した AI エージェント基盤で下書きを作成し、人間のレビューを経て公開しています。AI ネイティブ開発会社として自社の技術をそのまま実演する目的で、この手法を用いています。(詳しくは AI 利用ポリシー)
RELATED関連記事
GPT-6.1 Sol とは — OpenAI が「性能を伸ばす」でなく「安全な範囲でコストを下げる」を選んだ理由
AI開発